Serverless dans mon homelab, consommation à la demande
Mon homelab compte un Mac mini M4 et 5 mini PC dont 2 allumés H24. Les autres hibernent et se réveillent à la demande
Contexte
Dans un homelab, souvent, on veut tout faire tourner en permanence : un cluster Proxmox avec plusieurs nœuds, un cluster Kubernetes, des conteneurs pour les petits services. On se retrouve avec du bruit, de la chaleur, et une facture d’électricité qui grimpe rapidement pour des services qu’on utilise rarement après tout.
Dans une maison, pour réduire la facture d’électricité et adopter un comportement plus économe, généralement les occupants éteignent les lumières, débranchent les appareils qui n’ont pas besoin d’électricité 7j/7, et surtout ils ne chauffent pas (pour les pays froids) ni ne climatisent (pour les pays chauds) une pièce vide.
Et bien pour homelab on peut appliquer la même idée : les services non essentiels hibernent par défaut, et se réveillent uniquement quand on en a besoin.
Objectif
Après cet article, vous saurez :
- Pourquoi un cluster Proxmox a besoin d’un quorum (un vote à la majorité) pour rester en vie, et comment une microVM apporte les voix des serveurs éteints pour le maintenir.
- Comment rallumer un serveur éteint avec Wake-on-LAN, déclenché depuis un cronjob Kubernetes.
- Comment KEDA scale down vos applications Kubernetes et les scale up lorsqu’il reçoit une requête HTTP comme les fonctions serverless du cloud telles que AWS Lambda ou Azure Functions.
- Comment DockerWakeUp fait pareil pour des conteneurs classiques (Podman ou Docker).
- Ce que ça fait gagner, et ce que ça coûte (parce qu’il y a un prix : l’attente appelée cold start).
L’image d’ensemble
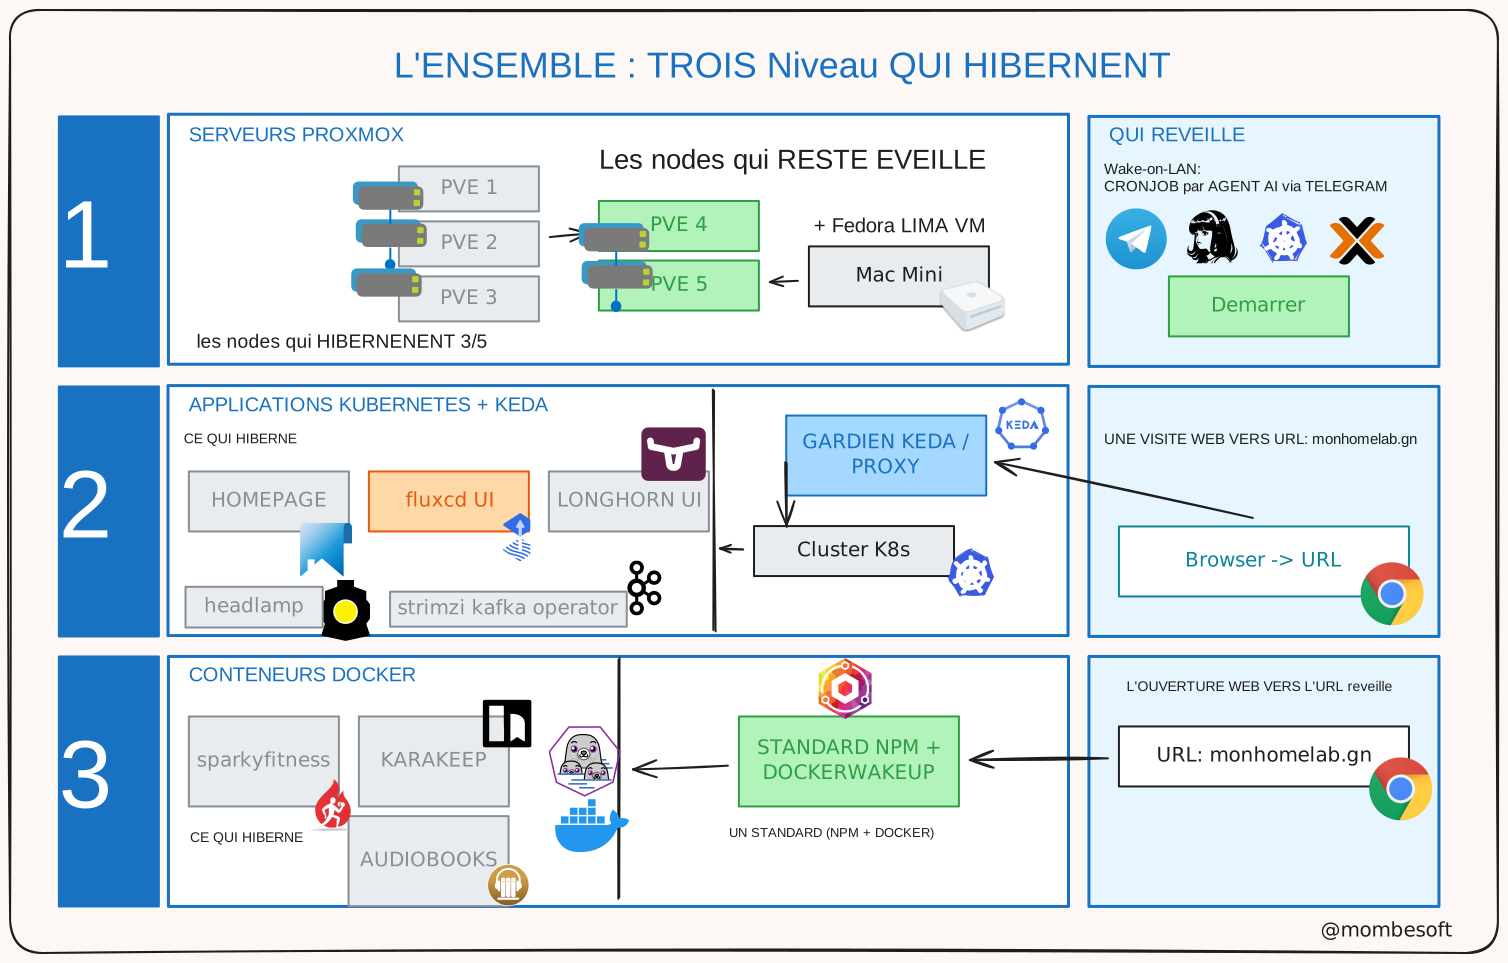
Le point commun : le visiteur ne voit aucune différence, à part quelques secondes d’attente au premier appel. C’est ce délai qu’on appelle le cold start (démarrage à froid), comme une voiture qui met quelques minutes à démarrer un matin d’hiver.
Prérequis
- Wake-on-LAN activé sur les serveurs Proxmox (dans le BIOS et dans l’OS).
- Un cluster Proxmox ou des machines physiques (le mien en compte 5 nœuds, mais le principe marche dès 2).
- Un cluster Kubernetes avec un gateway (Talos Linux + Cilium Gateway).
- Un hôte serveur physique ou VM Linux (Docker ou Podman) avec un reverse proxy (Nginx Proxy Manager ou Traefik + DockerWakeUp).
- Un contrôleur KEDA avec l’add-on http installé sur le cluster Kubernetes.
- VM/Physique pour jouer le rôle du QDevice (de préférence hors du cluster proxmox) : une microVM Linux. Personnellement, j’utilise Lima sur Mac mini mais ça peut être une VM Linux sur un serveur physique, ou même un Raspberry Pi.
I. Le Wake-on-LAN, deux serveurs allumés (24/7) sur cinq + un QDevice
Mon homelab compte 5 serveurs Proxmox, mais seulement 2 sont allumés H24. Les 3 autres hibernent et se réveillent à la demande. Je les allume ponctuellement pour tester de nouvelles fonctionnalités ou lancer des compilations lourdes. Le reste du temps, ils hibernent pour économiser de l’énergie.
Élection : le quorum, c’est la majorité
Les serveurs Proxmox d’un cluster se surveillent entre eux en permanence. Pour prendre une décision (démarrer une machine virtuelle, par exemple), il faut plus de la moitié des voix : c’est le quorum. Pensez à un conseil d’administration : à 5 autour de la table, il faut 3 voix pour décider.
Si j’éteins 3 serveurs sur 5, il n’en reste que 2 : 2 voix sur 5, pas de majorité, le cluster se fige pour se protéger (en mode lecture). Impossible de créer de nouvelles machines virtuelles, impossible de démarrer celles qui étaient éteintes.
Pourquoi a-t-on besoin d’un QDevice ?
Proxmox permet d’ajouter un QDevice : un tout petit programme qui vote à la place des absents. Avec un réglage un peu particulier, mon QDevice apporte 4 voix. Faisons le calcul :
| Situation | Voix | Verdict |
|---|---|---|
| 5 serveurs + QDevice | 9 sur 9 | Le cluster décide |
| 2 serveurs + QDevice | 6 sur 9 | Le cluster décide quand même |
| 2 serveurs sans QDevice | 2 sur 5 | Le cluster se fige |
Le QDevice tourne dans une toute petite microVM (qdevice-vm) hébergée sur mon Mac mini grâce à Lima (un outil qui fait tourner des machines virtuelles Linux sur Mac). Elle a une vraie adresse sur mon réseau local, attachée au port ethernet de son hôte, et ne fait qu’une seule chose : voter. Elle consomme à peine 200m de CPU et 200Mo de RAM, le Mac mini est peu énergivore.
Monter un QDevice sur un cluster de 5 nœuds n’est pas officiellement supporté par Proxmox : il faut forcer l’installation avec
pvecm qdevice setup --force. Ça marche, mais le Mac mini devient critique : s’il s’endort, les 2 serveurs restants perdent leur majorité et tout se fige. Mon Mac ne dort donc jamais grâce à un outil comme Amphetamine. Guide de configuration du QDevice : saturnme.com.
L’important : éteindre et rallumer les 3 serveurs ne change jamais la liste des membres du cluster.
Réveiller un serveur proxmox : Wake-on-LAN
Un serveur qui hiberne n’est pas vraiment éteint, sa carte réseau reste à l’écoute. Le Wake-on-LAN consiste à lui envoyer un paquet magique : un message réseau spécial contenant 16 fois son adresse MAC, et il se rallume.
En version la plus simple possible, sans rien d’autre que la bibliothèque standard Python :
1
2
3
4
5
6
7
8
import socket

MAC = bytes.fromhex("e4b97afb0abf")  # l'adresse MAC du serveur endormi
packet = b"\xff" * 6 + MAC * 16  # 6 octets 0xFF, puis la MAC 16 fois

with socket.socket(socket.AF_INET, socket.SOCK_DGRAM) as s:
    s.setsockopt(socket.SOL_SOCKET, socket.SO_BROADCAST, 1)
    s.sendto(packet, ("192.168.x.255", 9))  # broadcast du VLAN, port 9 (discard)
Lancé depuis mon laptop, qui est branché sur le même switch que les serveurs : ça marche. La carte réseau voit son adresse MAC, réveille la carte mère, et quelques dizaines de secondes plus tard le serveur rejoint le cluster tout seul.
Pourquoi passer par l’API Proxmox depuis Kubernetes ?
J’utilise donc des cronjobs Kubernetes pour réveiller ou hiberner les serveurs quand j’en ai besoin. Sauf que ça ne marche pas : le paquet magique n’atteint jamais la carte réseau endormie.
Deux contraintes entrent en collision :
- Une carte réseau en veille n’a pas d’adresse IP : elle ne parle ni TCP ni TLS, elle attend un broadcast qui circule sur son câble. Impossible de la « contacter » directement depuis l’extérieur du VLAN.
- Un pod Kubernetes ne vit pas sur ce même câble : il est dans le réseau du cluster (Cilium, VLAN dédié, overlay). Ses broadcasts ne sont pas propagés sur le VLAN des serveurs, et c’est très bien comme ça, d’un point de vue sécurité : un broadcast WoL qui traverserait tout le réseau permettrait de réveiller des serveurs d’autres VLAN.
Résultat : mon cronjob s’exécute, le paquet « part », mais la carte réseau endormie ne reçoit rien. C’est la limite classique du Wake-on-LAN : le paquet magique ne traverse pas les réseaux.
La solution n’a rien de compliqué : pve1, un nœud du cluster Proxmox, est déjà allumé 24/7 et branché sur le même switch que les dormeurs. Je lui transmets donc l’ordre d’envoyer lui-même le broadcast, via son API REST, voir plus de détails dans la documentation Proxmox : Wake-on-LAN via l’API.
1
2
3
curl -sk -H "Authorization: PVE $PROXMOX_API_TOKEN" \
  https://<pve1>:8006/api2/json/nodes/pve3/wakeonlan \
  -X POST
Dans mon cas, c’est un petit CLI Python qui fait ce curl pour moi : homelab-automation proxmox wol --target-node pve3.
Proxmox construit le paquet magique et l’envoie depuis sa propre carte réseau, physiquement branchée au bon endroit.
II. Utiliser KEDA pour scaler à zéro sur Kubernetes
Pour le contexte, j’ai un cluster Kubernetes qui tourne sous la distribution Talos Linux. Il est composé de 5 VM (nœuds Kubernetes) et tourne sur 3 serveurs Proxmox.
KEDA est un projet open source qui permet d’autoscaler des applications basées sur des événements. Il est particulièrement utile pour les applications qui ne sont pas utilisées en permanence, car il peut réduire le nombre de réplicas à zéro lorsqu’il n’y a pas de trafic, et les augmenter à nouveau lorsqu’il y a des demandes, nous utiliserons pour cela son extension HTTP add-on.
Choix des applications à hiberner
Sur mon cluster Kubernetes tournent des outils que j’ouvre rarement : contrôleurs k8s, opérateurs ainsi que des dashboards ou applications qui ne sont pas utilisés tous les jours.
L’idéal serait de les éteindre complètement… mais de base, Kubernetes ne sait pas les rallumer tout seul quand quelqu’un veut les utiliser. D’où KEDA.
J’ai des cronjobs qui réveillent de temps en temps des contrôleurs pour faire des mises à jour, mais la plupart du temps, ils sont endormis. Quand je veux les utiliser, je les réveille avec KEDA.
Fonctionnement :
Le mécanisme ressemble à l’accueil d’un magasin fermé :
- Vous arrivez devant la porte (vous ouvrez l’adresse mon_super_app.com).
- Le receptionniste (un petit proxy appelé interceptor) vous accueille et vous demande de patienter.
- Il appelle le vendeur : KEDA scale up l’application.
- Quand elle est prête, le gardien vous fait entrer : votre page s’affiche.
Votre première visite met donc quelques secondes de plus (le cold start), mais elle réussit.
Une règle simple, répétée partout
Chaque application qui hiberne suit le même modèle, simplement : « zéro pod au repos, une seule suffit quand il y a du monde, et on rendort après 15 minutes sans visite » :
1
2
3
4
5
spec:
  scaledownPeriod: 900 # 15 minutes sans visite -> on rendort
  replicas:
    min: 0 # zéro pod quand personne ne vient
    max: 1 # une seule pod suffit pour un usage familial
Vous pouvez ajuster le temps de sommeil à votre convenance, mais 15 minutes est un bon compromis : ça laisse le temps de naviguer dans l’application, et ça ne consomme pas de ressources quand on ne l’utilise pas.
III. Comment appliquer le même principe aux conteneurs classiques (Podman/Docker)
Le même gardien, pour les petits services qui tournent dans des conteneurs docker.
À côté de Kubernetes, j’ai aussi des services simples qui tournent en conteneurs. C’est souvent des applications web, des dashboards, ou des outils de monitoring.
Ils tournaient en permanence, mais je ne les utilise pas tous les jours. Je veux donc qu’ils hibernent eux aussi, et se réveillent à la demande. C’est là qu’intervient la solution DockerWakeUp, qui joue exactement le même rôle que le gardien KEDA, mais pour les conteneurs classiques.
Fonctionnement :
Techniquement, le mécanisme est simple :
- NPM (Nginx Proxy Manager) reçoit les visites chiffrées (HTTPS grâce à Let’s Encrypt) et les transmet au proxy de réveil en gardant le nom demandé.
- Le proxy DockerWakeUp regarde le nom demandé (
audiobookshelf) → il lancepodman compose up -ddans/opt/audiobookshelf, puis transmet la visite. - Après 15 minutes sans visite (
idle_threshold: 900), il arrête le service avecpodman compose stop.
Chaque service est déclaré simplement avec son nom de route, son adresse locale, sa commande de démarrage et sa commande d’arrêt :
1
2
3
4
- route: 'audiobookshelf'
  target: 'http://127.0.0.1:8080'
  startCommand: 'cd /opt/audiobookshelf && podman compose up -d'
  stopCommand: 'cd /opt/audiobookshelf && podman compose stop'
Ce que ça fait gagner, honnêtement
Ce que je gagne :
- 3 serveurs éteints la plupart du temps : moins de bruit, moins de chaleur, une facture d’électricité allégée.
- La mémoire et le CPU du cluster Kubernetes libérée par plusieurs applications endormies.
- Services docker qui ne consomment plus rien quand je ne m’en sers pas.
Ce que ça coûte :
- Quelques secondes d’attente au premier appel (cold start), à chaque étage : ~1 minute pour un serveur, quelques secondes pour un pod ou un conteneur. Mais soyons honnêtes : c’est un homelab dont je suis le principal utilisateur, pas un service critique pour des millions d’utilisateurs.
- De la complexité : trois gardiens à maintenir, un Mac qui ne doit jamais dormir (il consomme peu), des réglages BIOS à ne pas oublier.
- Des paris assumés : QDevice forcé non supporté officiellement.
Ressources utiles
- Proxmox : quorum avec QDevice
- KEDA HTTP add-on
- DockerWakeUp
- Lima (VM Linux sur Mac)
- KEDA ScaledObject vs HTTPScaledObject
Conclusion
Le serverless n’est pas une magie réservée au cloud : c’est une discipline : ne rien laisser allumé sans raison, et savoir réveiller vite. Dans mon homelab, elle s’applique à trois échelles : les serveurs se réveillent par paquet magique, les pods et les conteneurs docker par visite HTTP. Le socle H24 tient sur 2 serveurs, une mini-VM qui vote, et trois petits gardiens qui consomment à peine de la mémoire et du CPU.